
所有筆記 · 發布於 2026-09-08
多益題庫夠不夠?10,672 題的使用紀錄,讓我們重新安排開發順序
Part 1 已有 4 個帳號做完整個題庫,Part 5 有 16 個,其他部分還沒有。但要決定下一步該加題、修題,還是幫大家調整練習方式,光看誰先刷完並不夠。我們把 9,854 份雲端備份拆開,檢查真正有作答的人、練得最多的人,以及七個 Part 之間的分配,結果也修正了自己對「刷太多短題」的直覺。
做練習 App,很容易把「再加一些題目」當成一個永遠正確的待辦事項。總題數增加,看得見、很好交代,首頁上的數字也比較漂亮。
但我想先知道:現在的題目,大家用到哪裡了?如果多數人還有大量沒碰過的內容,再加一千題,對他明天打開 App 的那次練習,究竟有多少幫助?
9 月 8 日,我們先跑了一次題庫覆蓋率報表,接著補查分布和跨題型的練習組合。看完之後,我的判斷是:目前沒有全面擴充題庫的急迫性;Part 5 的重度使用者值得持續照顧,而更大的開發機會,在於幫大家把現有題庫用得更好。
這個判斷不能只靠「幾乎沒有人做完」來支持。那句話太容易把真正需要新題的人,埋進一大群剛開始使用的人裡。
先換對分母:有備份,不等於練過這個 Part
這次共有 9,854 份帳號備份,其中 5,222 份留有目前 TOEIC 題庫的作答紀錄。其餘 4,632 份沒有這類紀錄,可能只用了單字等其他功能,也可能還沒開始練題;這次查詢不能區分。
所以不能把「做完 Part 5 的 16 個帳號」直接除以 9,854,就宣布需求小到可以忽略。比較合理的第一個分母,是至少做過一道 Part 5 的 3,957 個帳號;再往下,還要看已經累積大量練習的人。
本文的「做過幾題」,都以不同題目計算。同一個帳號把一題重做十次,仍然只算一題;不同帳號各做一次,則各留一筆紀錄。七個 Part 合計有 847,096 筆「帳號 × 不同題目」的作答紀錄。這不是總作答次數,也不能拿來換算實際學習時數。
以下資料以 2026 年 9 月 8 日的報表與同日 23:08 UTC 的唯讀補查為準,只涵蓋雲端備份,進度停在各帳號最後一次同步。
題庫快用完的人,集中在哪裡?
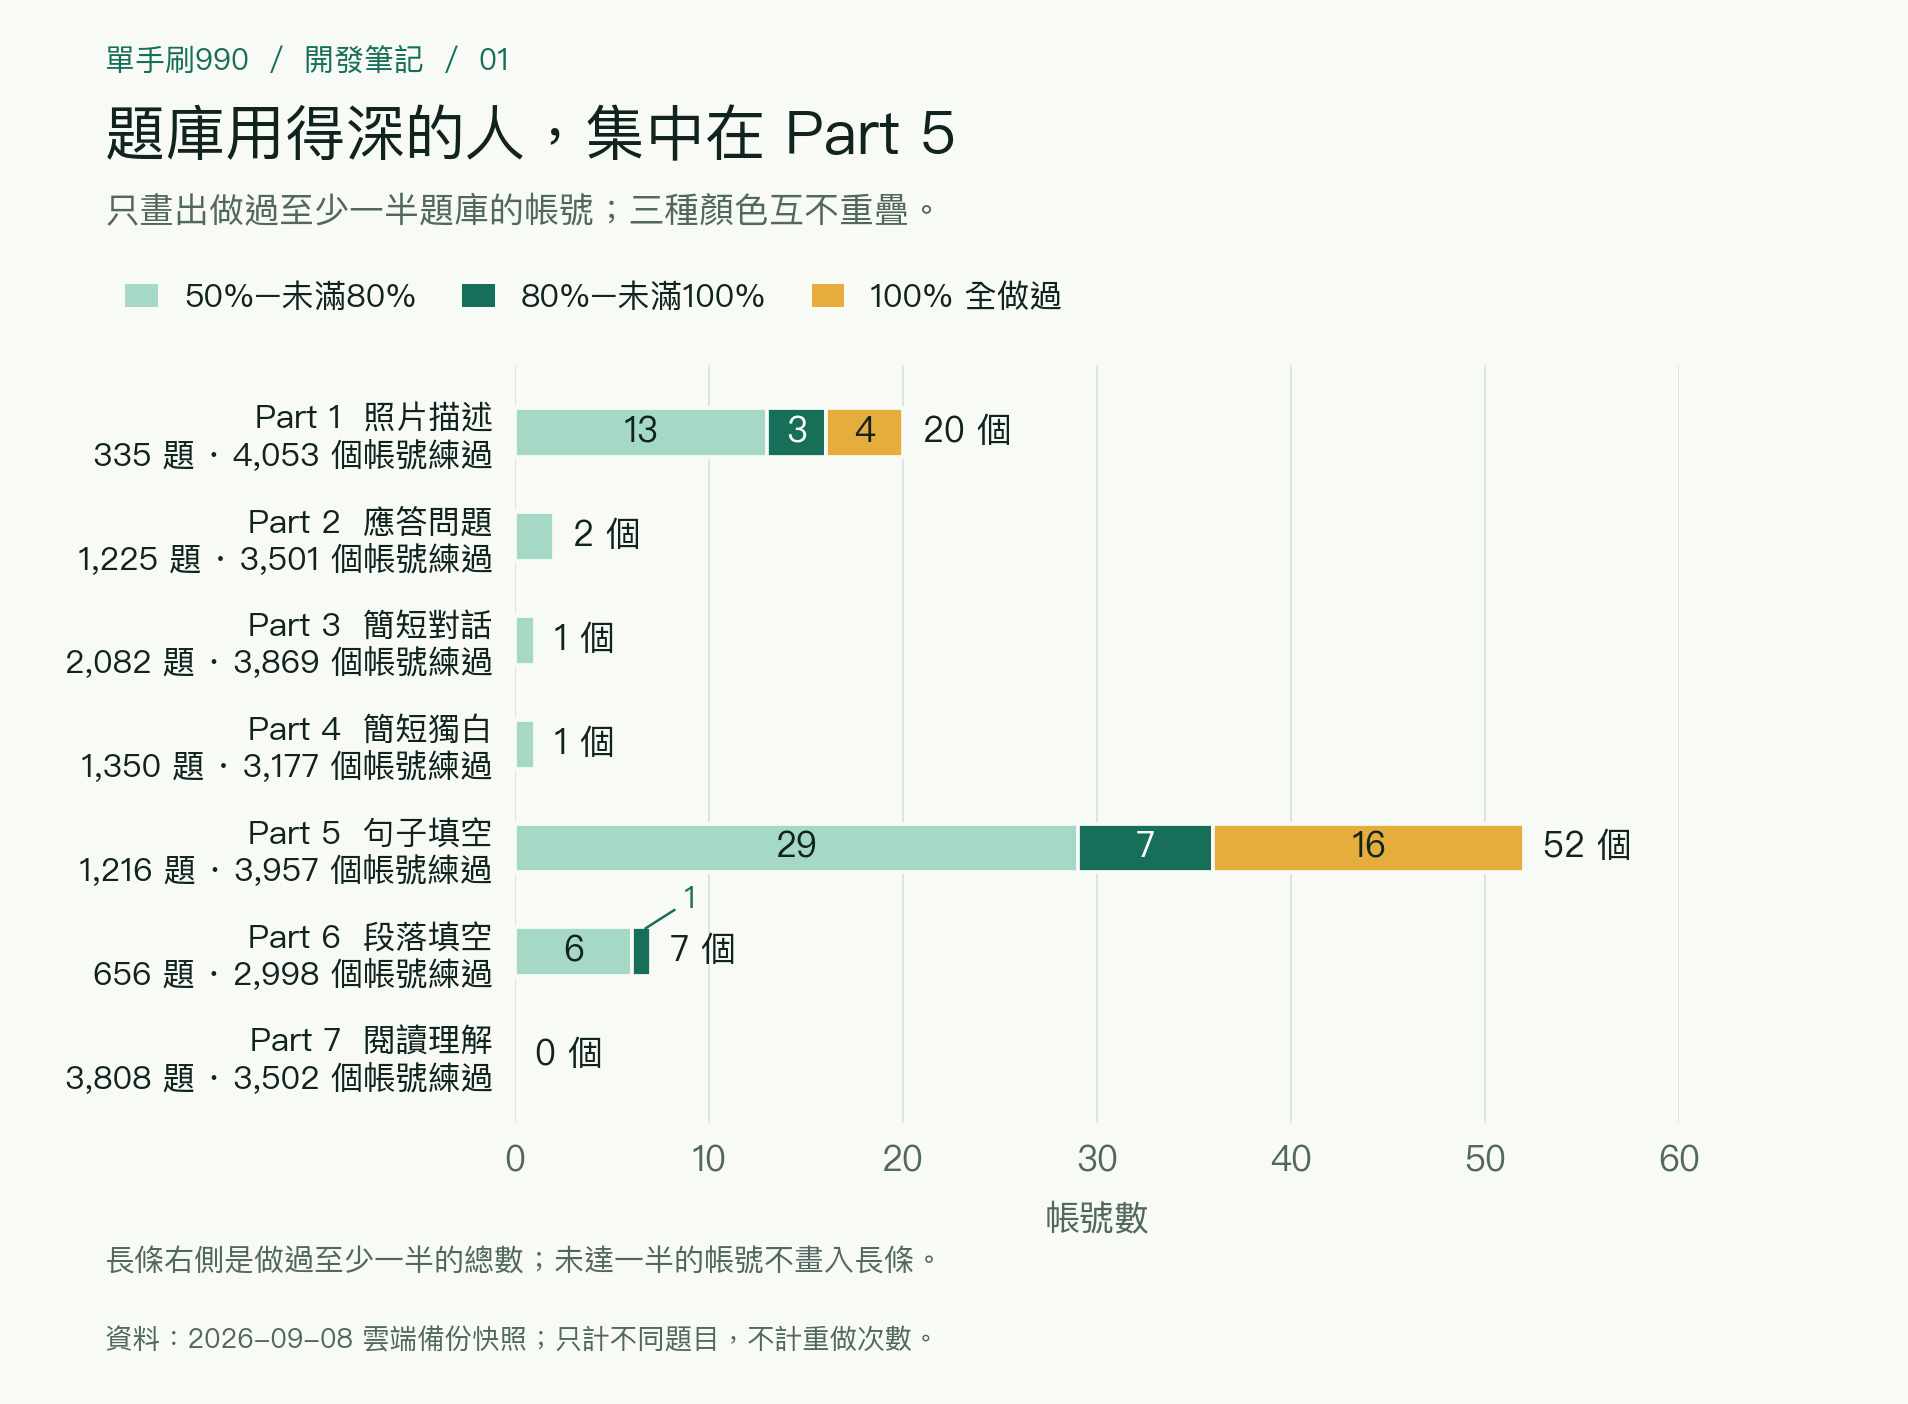
圖一:每條長條只包含做過至少一半題庫的帳號。三種顏色互不重疊,可以相加;不同 Part 仍可能是同一個帳號。可放大的 SVG
Part 1 和 Part 5 的確有人走到題庫底端。但其他部分,連做過一半的人都很少:Part 2 只有 2 個、Part 3 和 Part 4 各 1 個,Part 7 則是零。
Part 6 是需要單獨盯著的例外。 雖然沒人做完,但最高已經做到 536/656 題,剩 120 題;有 7 個帳號越過一半。若只寫「除了 Part 1、5 都綽綽有餘」,就會把下一個可能需要補充的地方漏掉。
再把視線從第一名往回移。在各自練過該 Part 的帳號裡,95% 的 Part 5 帳號做題數不超過 284 題,約題庫的 23.4%;Part 2 不超過 95 題,約 7.8%;Part 7 不超過 121 題,約 3.2%。這些數字支持的是「目前大多數觀察到的使用者還有大量餘裕」,並不是「大家永遠都不需要新題」。
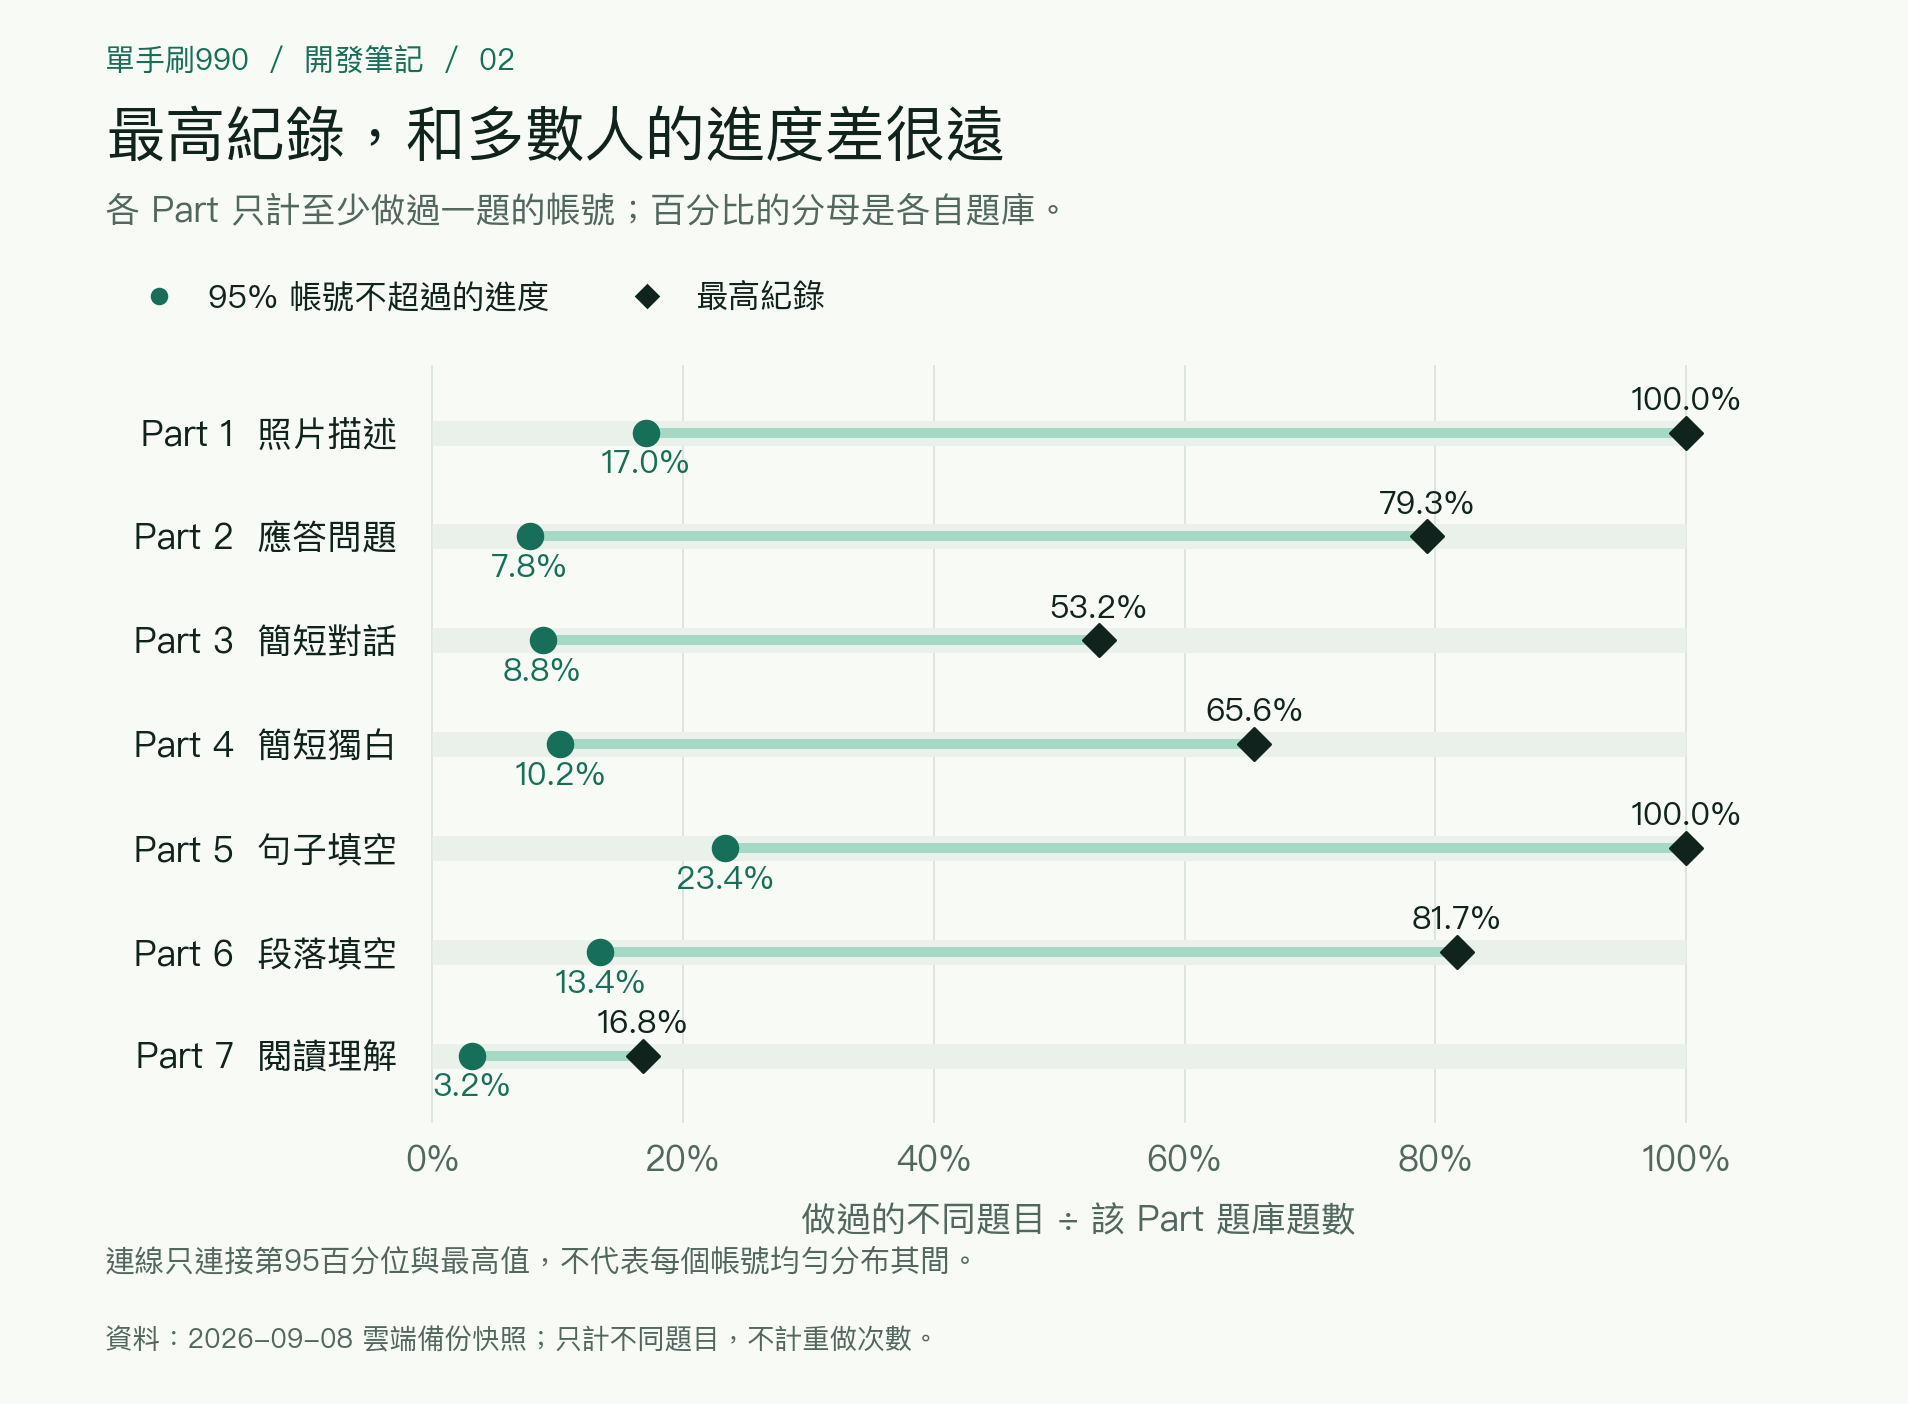
圖二:綠點是95%的帳號不超過的進度,菱形是最高紀錄;各 Part 只計至少做過一題的帳號。兩點之間的線不表示帳號均勻分布。可放大的 SVG
不過,低覆蓋率也可能只是新手很多。我們因此另外挑出七個 Part 合計做過至少 1,000 道不同題目的 144 個帳號。
這群人裡,23 個已經做過八成以上的 Part 5,16 個已經做完。換算起來,約六分之一接近底端,九分之一已經到底。這個分組本來就會納入所有刷完 1,216 題 Part 5 的帳號,不是獨立的需求預測;但它提醒我們,同一件事放在重度使用者身上,並不算罕見。
因此,我傾向降低大量擴題的優先順序,同時持續觀察這群人的需求。不能只因為占全部帳號的比例小,就假裝他們不存在。
Part 1 和 Part 5 都有人刷完,原因卻不能混在一起
我原本的直覺是:是不是有人太沉迷短題,應該提醒他換個地方練?
把跨 Part 紀錄攤開後,這句話需要收回一半。
做完 Part 1 的四個帳號,也都有練 Part 2、3、4。 他們在這三個部分的做題數中位數,分別是 603.5、613.5、417 題。這看起來是一群聽力練得很多的人,Part 1 比較早被他們走完,不能因此說他們只待在照片題裡。
Part 5 的情況比較值得注意,但也不是整齊的一種人。做完的 16 個帳號中,14 個碰過全部七個 Part,11 個在 Part 2、3、4、6、7 各自都做過至少一回正式考試相當的題數。另一方面,這 16 個帳號的 Part 7 做題數中位數是 182.5 題,和已經完成的 1,216 題 Part 5,確實有明顯差距。
這些資料讓提醒的設計變得具體:「做完題庫」適合拿來判斷內容供應;「最近練習分配是否失衡」,才適合拿來判斷要不要建議換個方向。
有人正在補文法基礎,有人已經把短題練得很熟,有人連長篇也做了很多。只看同一個 100%,很容易對三種人說出同一句不合適的話。
真正值得比較的,是練習分配與考試需求
正式的 200 題 TOEIC 聽讀測驗中,Part 1 有 6 題、Part 5 有 30 題,合計占題數 18%;Part 3、4、7 合計有 123 題,占 61.5%。這是題數占比,不是分數占比,也不代表每個人的練習時間應該照比例切。ETS《TOEIC Listening & Reading Examinee Handbook》,標準測驗格式
我們的作答紀錄裡,Part 1 加 Part 5 占了 37.8%。Part 5 單獨占 30.9%,Part 7 則占 12.0%。短題的確占了相當大的份量,但這仍然是不同題目的數量;讀一組長篇需要多久、重複複習了多少次,都不在裡面。
為了讓尺度比較接近,我們把前面那 144 個大量練習帳號,各 Part 的做題數中位數,除以正式考試該 Part 的題數:
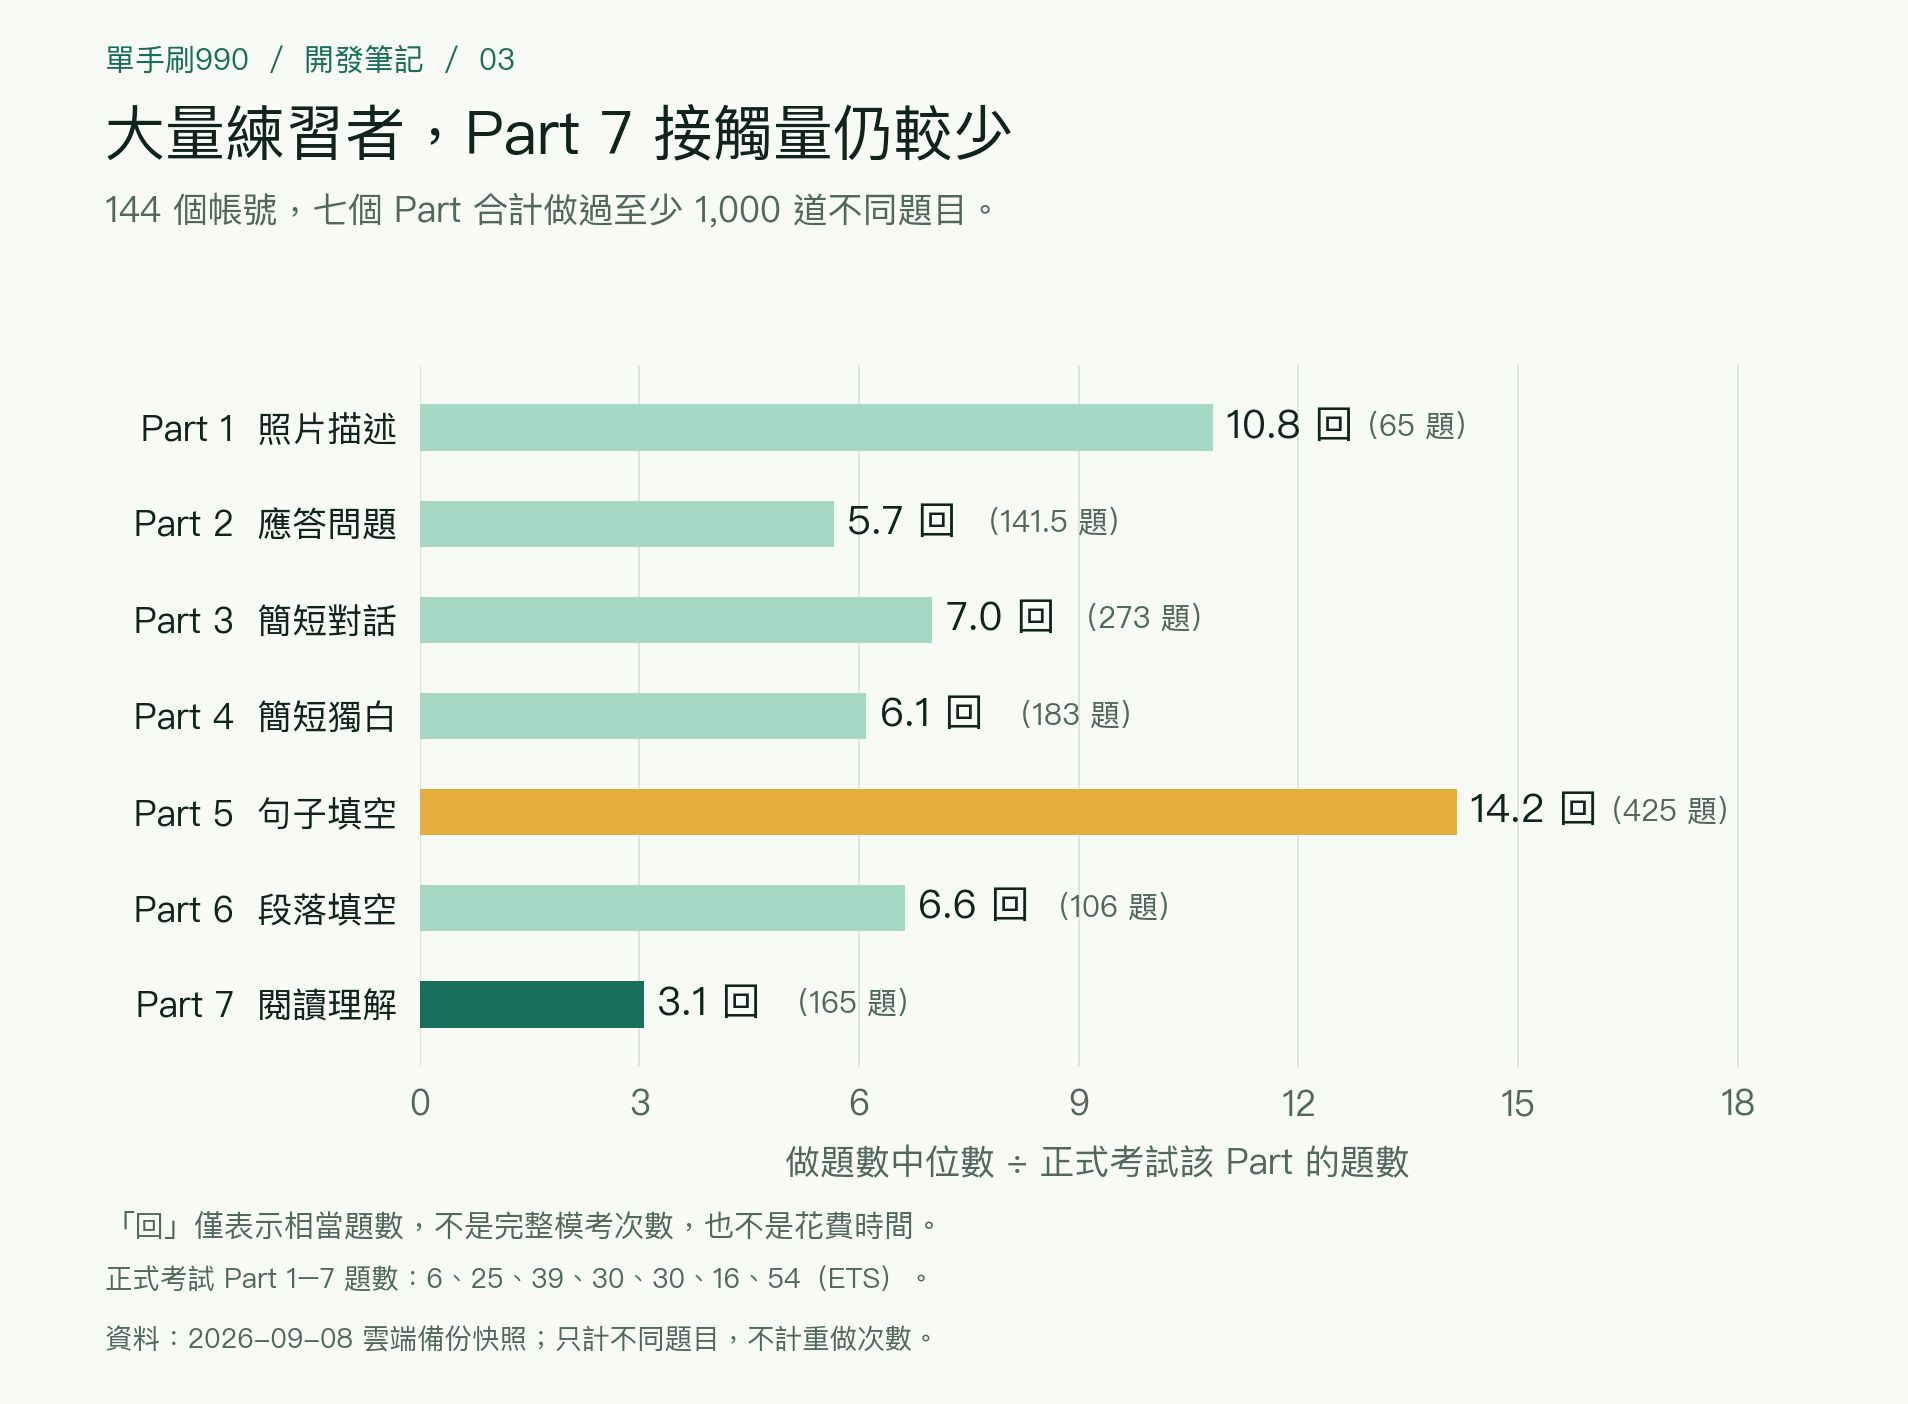
圖三:這是累計不同題目的量級換算,不代表做過這麼多回完整模考,也不衡量文章難度、閱讀量或花費時間。每個 Part 的中位數不一定來自同一個帳號。可放大的 SVG
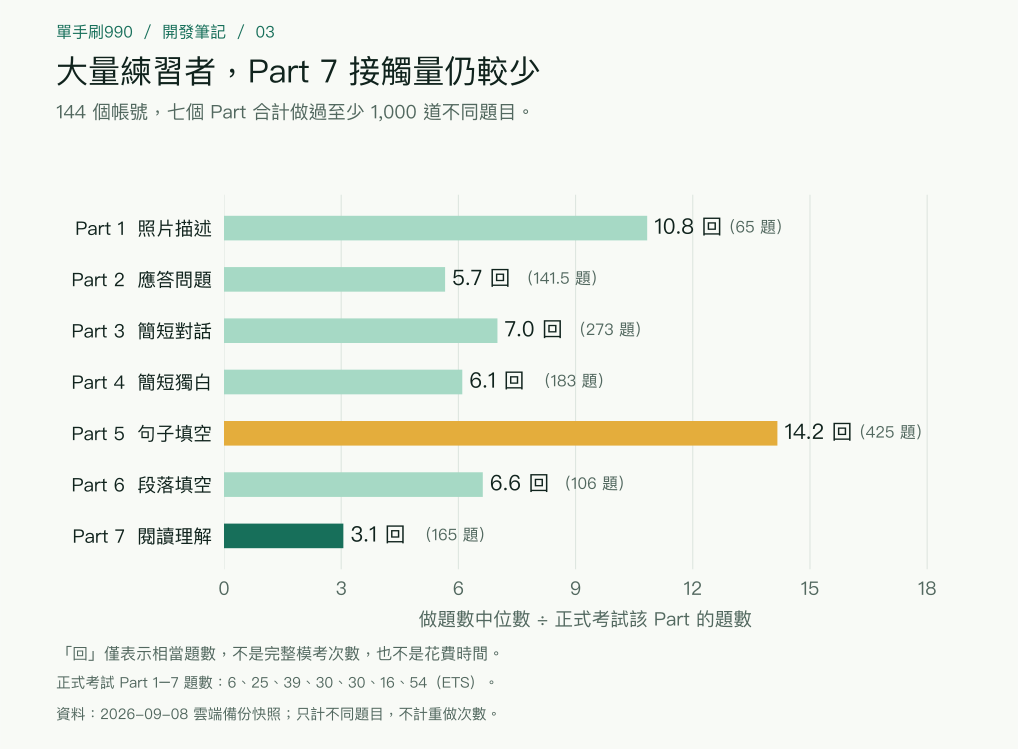
Part 7 的差距,在排除大量淺度使用帳號、又調整考試題數之後,仍然存在。 相對於考試會遇到的題數,這群人接觸的 Part 5 題量明顯比較多。
這就是我所說的「主要戰場」:在文法和短句已經有一定基礎之後,長對話、獨白、篇章閱讀仍有大量內容要應付。它不表示 Part 5 不重要,更不能從這張圖算出「把十分鐘挪去 Part 7 就會多幾分」;它提供的是一個值得檢查練習安排的理由。
Part 2 沒被做完,意外在哪裡?
Part 2 有 1,225 題,Part 5 有 1,216 題,兩個題庫只差 9 題。但前者沒人做到八成,後者有 23 個帳號做到八成,其中 16 個做完。
所以這個差異,不能只用「Part 2 題庫比較大」解釋。
兩邊開始練習的帳號數也沒有差到數倍:Part 2 是 3,501,Part 5 是 3,957。但累計的「帳號 × 不同題目」紀錄,Part 5 是 Part 2 的 3.13 倍。Part 5 的深度使用,明顯延伸得更遠。
再只看兩個 Part 都練過的同一群 3,054 個帳號,Part 5 做題數中位數是 22,Part 2 是 10。約 79.1% 的帳號做過比較多 Part 5 題目。不過,按正式考試的 30 題對 25 題校正後,Part 5 練得較多的比例降到 58.2%。
這個降幅很值得保留:它表示「整體總量差三倍」不等於「每個人都在 Part 5 花了三倍力氣」。帳號之間的分布,以及深度使用那一端的差異,都影響了總量。
我的猜想是,文字短題比較容易隨手做,聽力則需要能播放音訊的環境,也比較難完全照自己的速度掃過去。但這次沒有查使用情境、實際停留時間或放棄原因,不能把猜想寫成結論。題目推薦方式、使用者程度和各功能的使用路徑,也可能參與其中。
目前 Part 2 第一名做到 972 題,還有 253 題;第二名做到 621 題。相比立刻再加一批,我更想先弄清楚:大家進入 Part 2 之後,什麼情況下會繼續練,什麼情況下會停?
Part 7 沒人做到兩成,並不代表題庫沒被使用
Part 7 題庫最大,直接比百分比確實容易吃虧。最高紀錄是 640/3,808 題,只有 16.8%,但 640 題本身已經是很可觀的練習量。
我們也把單篇、雙篇、三篇分開,避免「某一類早就做完,被總數掩蓋」:三類各自最高的覆蓋率是 15.8%、34.5%、20.0%,仍然都不到一半。它們是各類自己的最高值,不一定是同一個帳號。
另一個角度更有意思:3,808 題裡,已有 3,807 題被至少一個帳號做過。 整個 TOEIC 題庫的 10,672 題,也只有這一題沒有出現在本次作答紀錄裡。
換句話說,內容在不同使用者之間有被分散使用;個別使用者還沒走多遠。大題庫仍然有價值:即使每個人只接觸一小部分,也有許多不同的題目實際進入練習。
但若要幫同一個人往前走,繼續把題庫加大,未必能解決他的問題。
在 3,502 個練過 Part 7 的帳號中,只有 500 個,約 14.3%,累計做到 54 道不同題目,也就是一回正式考試的 Part 7 題數。這不能當成課程流失率,因為每個帳號加入多久不同;它卻很清楚地指出,有大量觀察到的練習還停留在較淺的位置。
如果下一個開發時段只能做一件事,我更想檢查長篇練習的入口、每次份量、暫停後接續的體驗,以及解析能否幫人願意再做下一組。這些都是待驗證的方向,資料還沒有指出哪一個才是真正的阻力。
做過全部,還剩下什麼可以學?
在做完 Part 5 的 16 個帳號中,12 個仍有題目的最後一次作答結果是錯的。這 16 個帳號的「最後仍答錯題數」中位數是 85 題。
這不是首答錯誤率,也不能判定他們現在一定還不會;但至少說明,題庫覆蓋率走到 100% 時,複習和釐清錯誤的工作未必已經結束。
反過來,最後答對也可能包含重做後記住答案。要知道能力能不能帶到新情境,仍然需要沒看過的題目。因此,「還有錯題可複習」不是永遠不補新題的理由。 對真正已經把舊題練熟的人,小批、針對性的陌生題仍有價值。
我們更需要分清楚的是:使用者缺的是新題、對舊題的理解,還是練習安排。這三件事,不能全靠增加同一類題目的數量來處理。
這份資料會怎麼改變開發順序?
目前我傾向把工作排成以下順序:
- 先把現有內容和回饋做好。 修正有問題的題目、解析和題型標籤,會改善正在被使用的練習。這次幾乎每一題都有人做過,維護現有題庫有很直接的受益對象。
- 把練習建議做得更貼近個人。 既有的「本週回顧」已經會留意練習過度集中在單一 Part;接下來想檢查的是,建議能否更好地結合近期分配、個人弱項和練習成果。若確實符合情況,可以說「最近句子填空練得很穩,今天要不要做一組閱讀?」這是改進方向,不是看到題庫完成就一律增加提醒。
- 追蹤 Part 5 的深度需求,以及 Part 6 接近底端的人。 Part 5 不急著全面擴充,但可以針對內容缺口和陌生題需求補充;Part 6 則要看接近用完的人是否持續增加。Part 1 目前的資料,比較支持照顧廣泛練習者,不能一律當成偏科問題。
- 讓新增題量有明確的觸發理由。 比起只看總題數,往後更值得追蹤近期仍在練習的人還剩多少沒看過的題目、多久再次遇到舊題,以及某些難度或子題型是否先用完。這需要持續觀察,單次快照不能推算多久後會缺題。
題庫擴充不是取消了,而是開始有比較具體的優先順序。對大多數人來說,眼前已經有很多能練的東西;開發端接下來要回答的,是怎麼讓那些內容更容易進入一次有用的練習。
數字的邊界
本文有幾個不能省略的限制。這是帳號備份的快照,不是全體使用者的追蹤研究:未登入、尚未同步的進度看不到,一個帳號也不必然等於一個人。沒有作答紀錄不能直接判定沒有學習,作答少也不能判定已經流失。
題目按照目前題庫的 ID 比對;新增題目會拉低覆蓋率,舊版或不在目前題庫的 ID 不計入。Part 3 還有 312 題被排在選題順序後方的保留題,因此我們另外排除它們重算:一般題池是 1,770 題,最高完成 942 題、約 53.2%,仍未接近用完。這次的餘裕不是靠把保留題算進去才成立。
最後,這些紀錄沒有告訴我們每題花多久、重做幾次、先後如何安排,也沒有證明哪種分配帶來多少分數進步。我們可以用它調整開發優先順序,還不能用它替每個使用者判決「你練錯了」。
我希望下一次回頭看時,能知道建議有沒有幫人開始並持續練習原本比較少碰的部分,以及那些練習有沒有真的幫上忙。那會比首頁的總題數又多了一截,更值得寫一篇開發筆記。
本文討論的是單手刷990 的 TOEIC Part 1–7 題庫,不含單字等補充練習。既有題目的品質如何檢查,寫在〈多益弱點分析可信嗎?題型標籤稽核〉;練習安排與能力判讀的設計,另見〈多益弱點怎麼補:準備方向建議是怎麼運作的〉。