
所有文章 · 發布於 2026-07-24
多益單字怎麼背:從頻率排序到 FSRS 記憶演算法
全世界的單字書都有一個共同的都市傳說:第一個字是 abandon,而大多數人也真的在那附近 abandon 了。這不是你的問題,是安排的問題——從 A 背到 Z 本來就是一種對人性的高估。這篇文章介紹我們在 app 裡設計的一整套機制:它們各自解決一個明確的問題,串起來則是一條完整的生產線。
三個老問題
打開任何一本單字書,你都會遇到同樣的三個問題:
- 該背哪些字? 英文詞彙數以萬計,考試會考的集中得多。花一個晚上背
serendipity很浪漫,但多益不考浪漫。 - 該從哪裡開始? 你不是從零開始的學習者。已經認識兩千字的人,被迫從第一頁的
able開始「複習」,那不叫複習,叫罰站。 - 背過的怎麼不忘? 記憶會衰退,而且衰退得毫無愧疚感。沒有安排的複習,等於辦了一張會自動扣款的退貨服務——把背過的字定期還回去。
單手刷990的單字模組,就是圍繞這三個問題設計的。以下依序介紹每個機制,以及它背後的取捨。
頻率排序:先背最值得背的字
我們的核心字庫收錄 3,775 個 TOEIC 核心單字,來源對齊主流的多益字表。但收錄哪些字只是第一步,真正影響效率的是順序。
語言學裡有個著名的經驗法則(Zipf 定律):詞彙的使用頻率極度不均——少數常用字包辦了絕大部分的實際文本。翻譯成白話:每個字的投資報酬率天差地遠。高頻字是績優股,每篇文章都出現;低頻字是彩券,也許整場考試就出現那麼一次,還出現在你猜對的那題。
因此我們替每個字標上真實語料的頻率排名,再依排名切成難度等級:每約 50 個字一級,目前的字庫共 76 級。第 1 級是最常用的字,等級越高越冷門。這條「頻率=難度」的軸線,是後面所有機制共用的座標系——健檢在它上面搜尋、練習在它上面取樣、地圖沿著它排列。
值得說清楚的取捨:頻率高不等於「簡單」,只等於「常見」。但對備考而言,常見度是比主觀難度更客觀的排序依據——它直接對應「這個字出現在你考卷上的機率」,而機率不會跟你客氣。
單字健檢:用二分搜尋找到你的起點
有了難度軸,下一個問題是:你站在軸上的哪裡?
傳統的做法是分級測驗:做五十題選擇題,換來一個「中高級」之類的模糊頭銜。我們的做法叫「單字健檢」,本質是二分搜尋(binary search)——沒錯,就是工程師拿來找 bug 的那一招,只是這次要找的是你的知識邊界:
- app 顯示某一級的整頁 50 個字,請你把不認識的字點出來。
- 你點出的數量決定判定: - 0 個不認識 → 這級對你是幼幼班,往更難跳; - 1–5 個不認識 → 缺口恰到好處,恭喜,你的知識邊界就在這裡; - 6 個以上 → 這級是天書,往更簡單退。
- 依二分搜尋收斂。76 個等級,最多只需要
輪——通常幾分鐘就結束。跟朋友說你用 log 時間複雜度做了英文分級,還能順便社交扣分。
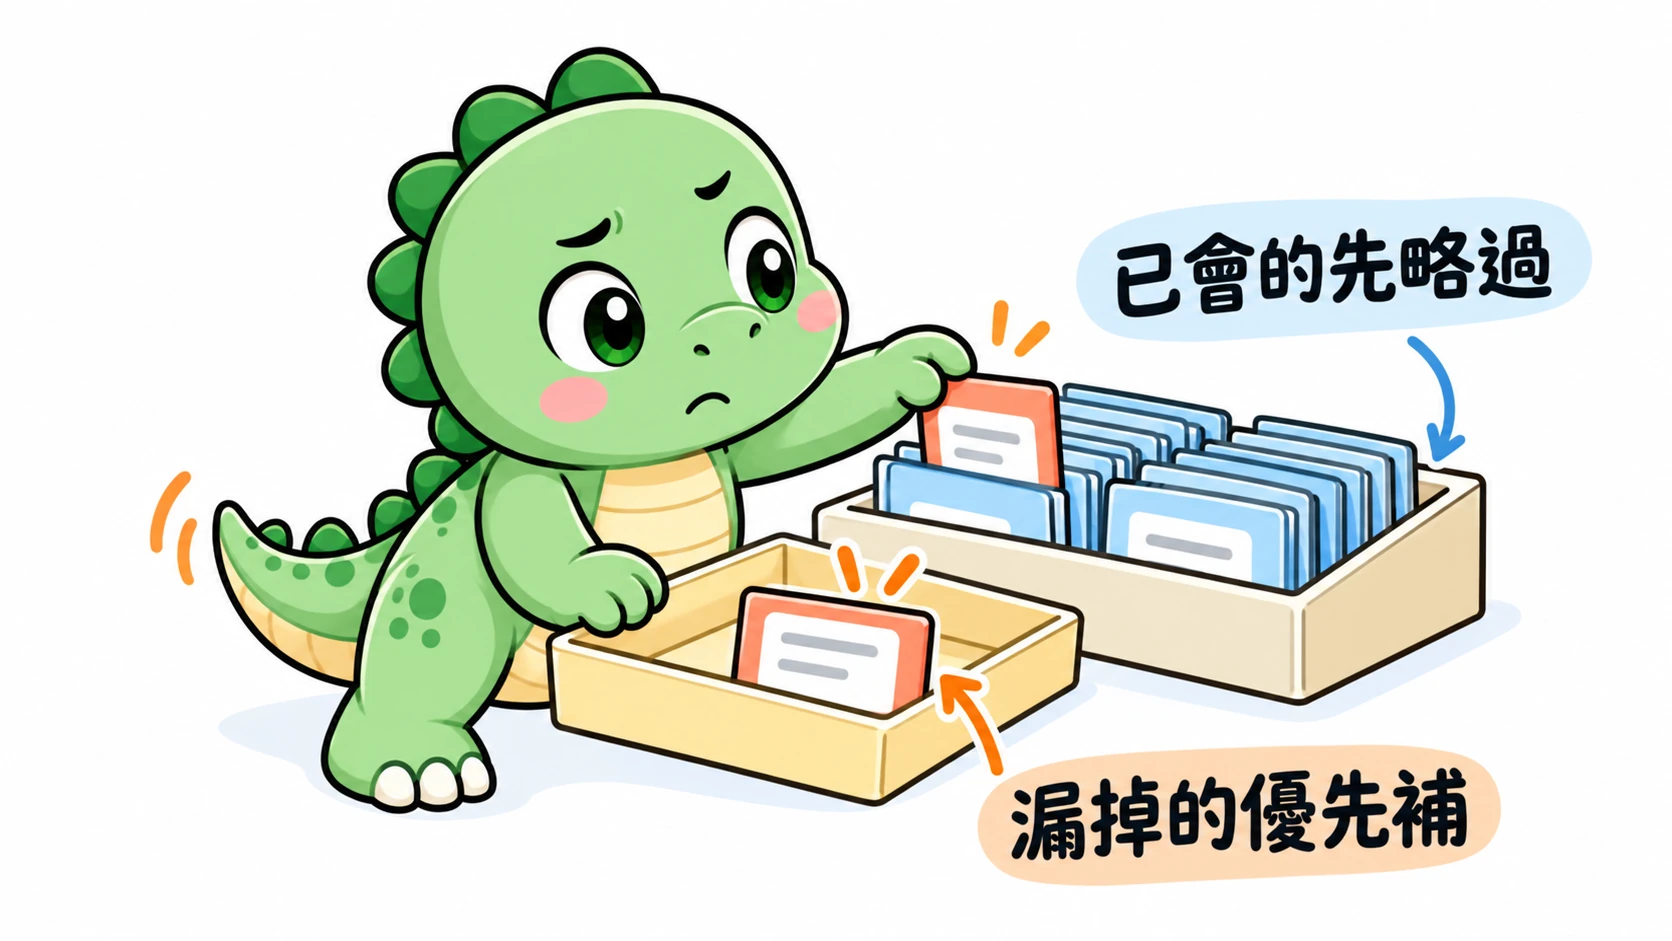
定位完成後的套用規則經過仔細設計:邊界以下的字全部標為「已知」,從此不再浪費你的時間。但有一個重要例外——你親手點過「不認識」的字,一個都跑不掉,它們直接排到學習佇列的最前面。健檢的過程本身就是你在替自己抓漏,抓到的漏洞當然要優先補,不能點完就裝沒事。
還有個防呆細節:被判定「太難」的那頁,沒點到的字不算你認識。一頁冒出六個以上生字時,多數人的真實行為是眼神逐漸失焦、直接翻頁——所以只有你的點選算數,你沒看完的部分,系統不替你簽名作保。
「我認識這個字」:永久封鎖
健檢處理的是「整批」的已知字;日常練習裡總還有漏網之魚。所以每張單字卡上都有一顆「我認識這個字」按鈕——點下去,這個字永久退出你的所有練習、複習與遊戲。
這其實是 Anki 的「suspend」概念。對一個已經認識 money 的人,任何演算法把 money 排給他,都只是在測試他的修養。封鎖清單跨裝置同步、隨時可以反悔解除,而且解除紀錄帶時間戳——就算兩台裝置的資料合併,也不會把你解封過的字又偷偷關回去。字庫不搞秋後算帳。
封鎖清單看起來是個小功能,實際上是整套系統裡最強的訊號:下一節的熟悉度模型和移動邊界,都蓋在它上面。
掃詞遊戲:把整理字庫變成一場街機遊戲
健檢是整批封鎖,按鈕是一次封鎖一個——說穿了,兩者都是文書作業。「掃詞遊戲」是同一件帳務工作換上了遊戲的外衣:單字從畫面右上滑進來,緩緩橫越、降一行、再折返,像輸送帶一樣蜿蜒而下。點一下,它唸給你聽;再點一下,它就爆開——標記為已認識,永久退出你的練習。你沒碰的字則安靜地從畫面底部走掉,什麼都不改變。不動手永遠是安全的——沒有字會因為「剛好出現在畫面上」就被下判決。
回合有兩種,規則只有一條:點掉那些不屬於眼前這批的字。「掃詞」回合出現的是你還在練的字,從你的等級一路往上爬——點掉已經認識的。「找回」回合則是鏡像:出現的全是已隱藏的字,從最高的隱藏等級一路往下走——點掉其實不熟的,它會爆回你的練習裡。找回模式的存在,是因為健檢會把邊界以下整片隱藏:統計上合理,個別來看難免有冤案——而被冤枉的字,多半就擠在邊界正下方,恰好是找回回合的起點。
其餘細節都為零碎時間調校過:回合長度以字數計(20、50、100 或全部)、速度三檔、可以打開「每個字出場就發音」的開關,結算頁列出這回合改動的每一個字,點一下就能反悔。它寫入的正是前面那份封鎖清單——這個遊戲沒有自己的分數,它唯一的計分板,就是你的邊界。
熟悉度模型與移動邊界:火力永遠對準「邊界」
健檢只在一開始跑一次,但你的程度每天都在變。如果練習永遠均勻亂數抽字,被安置在第 30 級的學習者,抽到第 3 級和第 70 級的字機率一樣——前者是浪費時間,後者是精神攻擊。
我們的解法分兩層:
第一層是熟悉度模型。 系統替每個字即時推導一個熟悉度,把你留下的所有痕跡——封鎖清單、複習排程的記憶狀態、測驗與拼字的作答、遊戲的成績、卡片的翻閱——融合成五個狀態之一:未知、看過、學習中、已知、精通。重點是這個分數永遠是當場推導、從不落地保存——來源資料一更新,熟悉度自動跟著對,不會留下一份過時的快照等著跟現實吵架。
第二層是移動邊界(frontier)。 你的「目前等級」同樣從封鎖清單即時推導:邊界就畫在已知與未知的交界上。練習抽字時,以邊界為中心做加權取樣:
| 區域 | 抽樣權重 | 用意 |
|---|---|---|
| 邊界以下較遠的等級 | 低 | 少量維持性複習,老朋友偶爾寒暄即可 |
| 邊界附近 | 全額 | 主戰場——正在攻克的字 |
| 邊界以上少量前瞻 | 中 | 先混個眼熟,為升級鋪路 |
因為邊界是推導出來的,它自動會動:你封鎖得越多、通過得越多,邊界就往上爬,練習重心跟著上移——不用重考健檢,也沒有任何額外的「進度條」需要同步。它就只是……跟著你走。
當系統看到你把目前等級大致掌握了,會主動提議「畢業這一級」:整級的字攤開給你看,你勾選確認認識的、整批封鎖;沒勾的字則被釘選起來繼續練。畢業證書是你自己按的,不是演算法偷偷頒的——但在對的時機把申請表端到你面前,是它的工作;而且你人在哪裡,它就送到哪裡:首頁的卡片上、複習結束的那一頁,或是地圖本身。
單字地圖:讓進度看得見
以上機制都在幕後運作,而「單字地圖」把它們變成一幅看得見的圖:每個字是一顆寶石,按難度等級一排一排鋪開,顏色就是熟悉度——從未知的暗色到精通的亮色——你的邊界線橫貫其中。
它的作用不只是好看。「3,775 個字」是一個聽了會胃痛的數字,但「地圖上亮起來的區域每週都在擴大」是一種具體的爽感。你一眼就能看到:哪些等級已經整片點亮、邊界推進到哪裡、已知區裡哪幾顆寶石還暗著——那些就是被釘選、還在補的漏洞,像已開發地圖上幾個還沒插旗的角落,看了就手癢。
點任何一顆寶石,它還會告訴你它為什麼是這個顏色——兩天前你答錯了、明天要複習、在閃卡裡看過六次。顏色是系統下的結論,這一行是它據以下結論的證據,兩者你都有權看到。
地圖同時也是發射台:每個等級列上都有一顆小小的遊戲手把按鈕,一點就開一場只掃這個等級的掃詞遊戲——看到哪一排該整理了,當場開掃。
智慧複習:把「什麼時候該複習」交給記憶模型
最後是對抗遺忘的部分。我們沒有發明自己的複習玄學,而是直接採用目前公開研究中表現最好的排程演算法之一:FSRS(Free Spaced Repetition Scheduler)——新一代 Anki 背後的那套記憶模型,我們用的是最新版 FSRS-6。
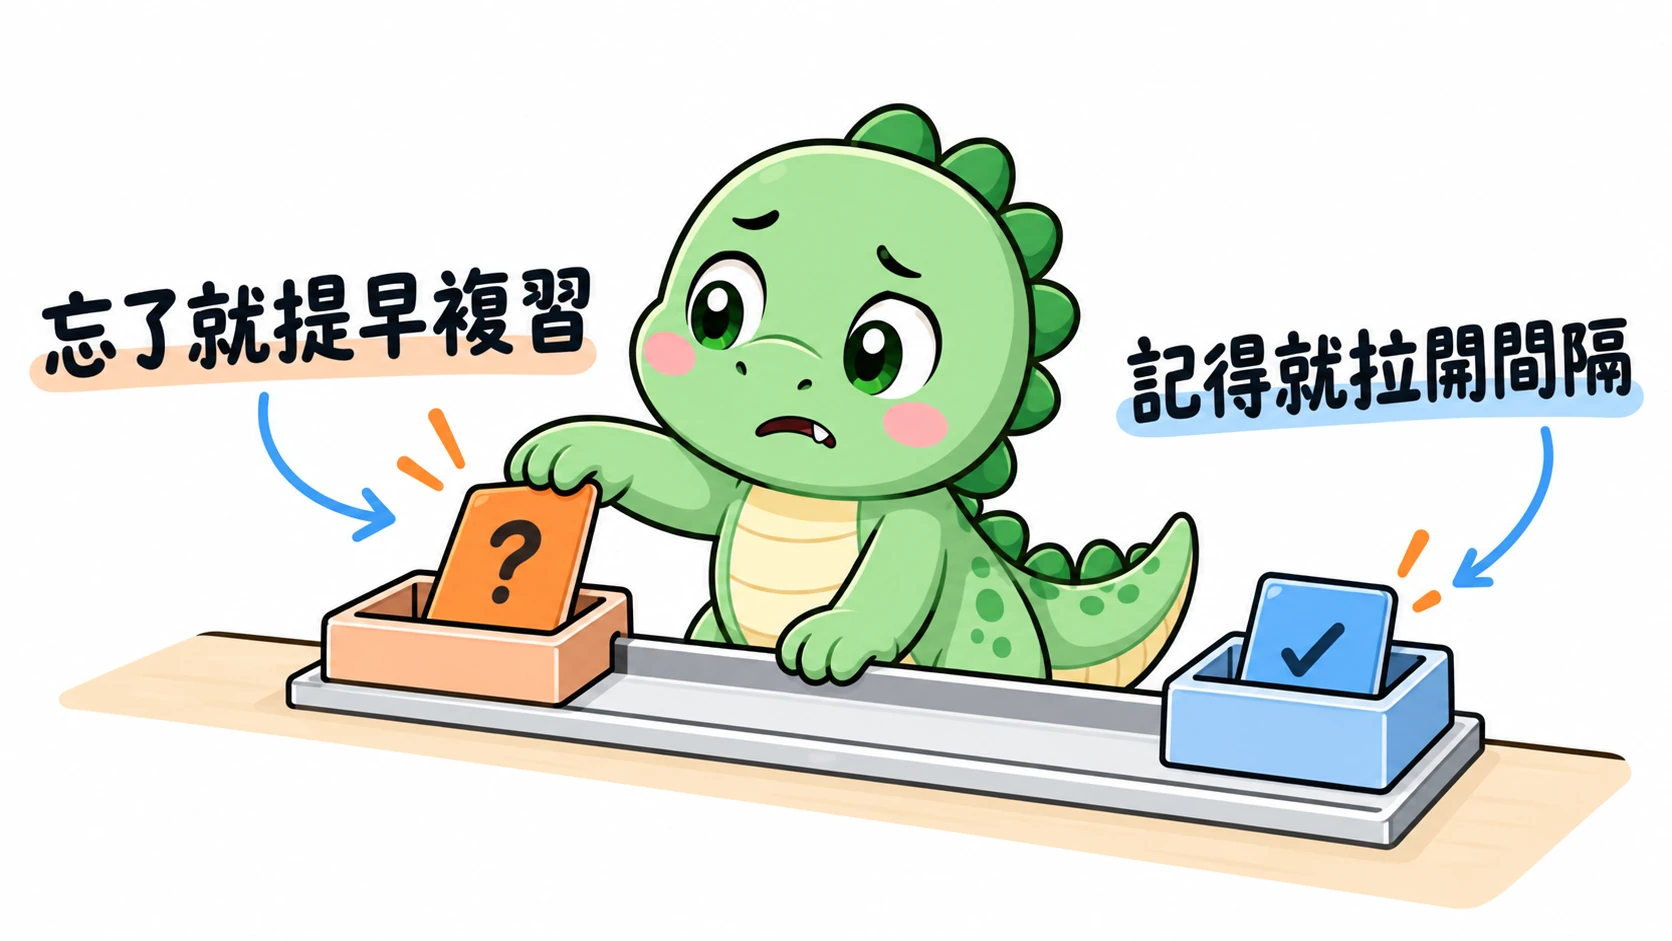
核心想法:每張卡片各自維護一個記憶強度的估計。答對,強度上升,下次見面的間隔拉長——幾天、幾週、然後幾個月;答錯,強度重估,這張卡很快就回來敲門。系統永遠把複習安排在「快要忘、但還沒忘」的時刻——那是每一次複習效益最高的甜蜜點,早了是浪費,晚了是重背。
介面上我們刻意克制:翻開卡片後只有 不會 / 記得 兩顆主按鈕(外加一顆次要的「很簡單」),不擺出 Anki 那面著名的四鍵牆——背個單字不需要先通過人機介面測驗。每天最多引入 20 張新卡,這個上限是刻意的:它擋在你和三千多字的字庫之間,防止第一天的雄心壯志變成第三天的已讀不回。而這些新卡是從你自己的等級開始、依難度順序進場的——所以「今天的新字」真的是排在你前面的下一批,不是從整個字庫裡隨手抓的。當天複習全部清空後,如果你正在興頭上,無限模式會解除當日新卡上限——今天要走多遠,你自己決定。
還有一個我們特別得意的設計:複習不只發生在複習裡。你在單字測驗、拼字練習、片語練習中的每一次作答,都回饋給同一套排程系統。在測驗裡剛答對的字,複習排程就順勢往後推——系統知道你剛剛見過它了,不會隔天又把同一個字端出來,假裝你們是初次見面。而當你答錯時,app 現在會當場告訴你:已加入智慧複習。這條鏈路一直都在,只是以前它默默地跑——而默默地跑,跟沒跑幾乎是同一件事。
周邊的支撐:讓每次相遇更有黏性
排程決定「何時見面」,但每次見面的品質同樣重要。死背一個孤零零的字,就像認識一個沒有臉書、沒有共同朋友的人——很快就忘。所以每張單字卡背後疊了好幾層內容,替每個字多裝幾個記憶掛鉤:
- 完整的字典層:多義項、詞性、詞形變化,每個義項配例句,例句附翻譯。
- 字源與詞根詞綴:
spect(看)認得一次,inspect、prospect、spectator就全變成了熟人的親戚。 - 搭配詞:
meet a deadline、place an order——多益考的常常不是字,而是字的交友圈。 - 三種口音發音:同一個字可聽美式、英式、澳洲腔——正是聽力測驗裡輪番登場的三位主持人。
- 記憶插圖:超過 96% 的字配有情境小插圖,給視覺記憶一個掛鉤。
- 拼字練習與 PDF 匯出:想動手寫、想印出來在捷運上翻,都有出口。
學習路徑:一次只給你一件事
上面每一項都是機制,而機制是會累積的。當健檢、測驗、拼字、閃卡、速查、複習佇列、地圖和遊戲同時排在一個畫面上,我們其實是悄悄地把「我該背哪個字?」換成了「我該按哪顆按鈕?」——後者是更糟的問題,而且是我們自己製造出來的。
所以單字區現在由一張卡片開場,它只指出一件事,而且永遠只有一件:
- 還沒開始 → 先找出你的程度:健檢,三分鐘
- 有字待複習 → 複習這些字
- 這一級看起來會了 → 升級
- 沒有到期的 → 學今天的新字;連新字都學完了,就什麼都不給
這個順序不是隨手排的。複習排在新字前面,因為你延後的複習是正在流失的字,而你延後的新字只是還沒認識的字。升級也排在新字前面,理由沒那麼直覺:升級會推動邊界,所以升級之後才引入的新字,來自你剛解鎖的那一級,而不是你已經唸完的那一級。
卡片上還有你的等級,等級下面有一條進度條。這兩者刻意量的是不同的東西。等級只在你畢業一整級時才會上升——這是設計使然,比起讓演算法在背後幫你升等,我們寧可由你親自替自己的知識背書——也就是說,你認真唸了一週,它可能一動也不動。真正每天都在動的是那條進度條:它是目前這一級裡已經變綠或變金的比例。複習把進度條填滿,畢業把填滿的進度條換成一個等級。如果你曾經很努力唸了一週、卻眼睜睜看著進度數字紋風不動,那道落差正是這條進度條要補的。
如果你想一次看完整條路線,標題就是按鈕:點一下單字,或點卡片自己的標題,整條路徑會展開成一頁——步驟的先後、每種練習從哪裡取字、你的每個動作實際改變了什麼。
設計哲學:一個迴圈,而不是一堆功能
把全部機制放在一起看,它們是同一個迴圈的不同段落:
頻率排序定義值得走的路 → 健檢找到你的起點 → 移動邊界讓練習永遠打在最有效的位置 → 封鎖與畢業把攻下的領土插上旗子、推著邊界前進 → FSRS 複習守住後方不失土 → 地圖讓你隨時看見這一切 → 而學習路徑確保你每一天都知道,今天輪到的是其中哪一件。
貫穿其中的原則只有三條:不浪費你已經會的(封鎖、健檢、跨練習的訊號回饋)、火力集中在邊界上(頻率軸、加權取樣、畢業提議),以及把記憶交給經過驗證的模型(FSRS,而不是憑感覺的「每日十字」)。第四條是後來才補上的——當前三條已經造出足以讓人迷路的機器之後:永遠說清楚下一步。
最後照例是誠實的但書:所有推導都在你的裝置上完成,健檢隨時可以重跑,封鎖隨時可以反悔——這套系統的每個判斷都以你的行為為準,也永遠保留你推翻它的權力。畢竟演算法的工作是安排;真正把這些字記住的,從頭到尾都是你。它只是負責確保:這一次,你不會又停在 abandon。